
ระดับเนื้อหา: Overview / Implementation considerations
หลักการและการเลือกใช้
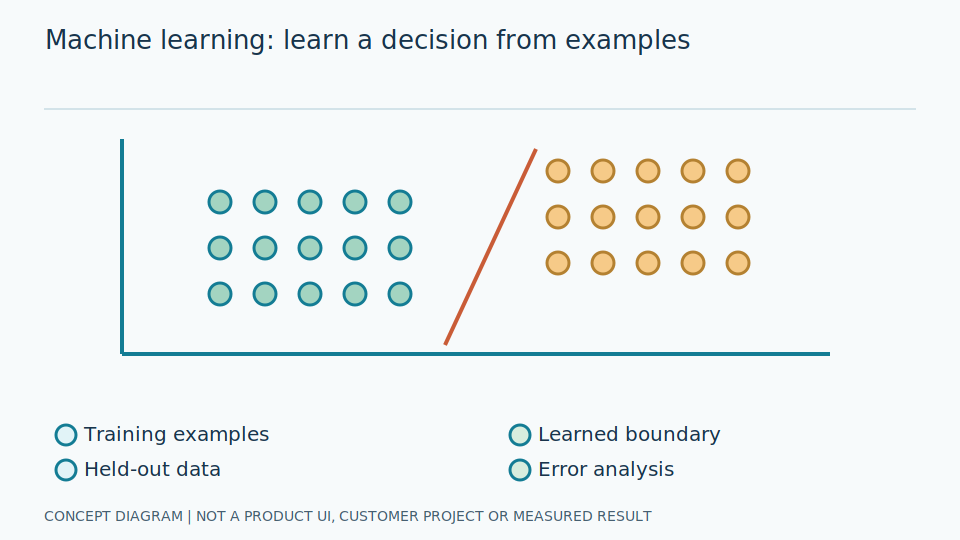
Machine Learning เรียนความสัมพันธ์จากข้อมูล ไม่ใช่กฎที่รับรองความถูกต้องทุกกรณี Supervised learning ต้องมีคำตอบ ส่วน unsupervised learning หารูปแบบโดยไม่มีคำตอบกำกับ การนำโมเดลไปใช้ไม่ได้แปลว่าจะเรียนรู้ต่อเอง
เปรียบได้กับการเรียนจากตัวอย่างที่มีขอบเขต ถ้าตัวอย่างส่วนใหญ่เป็นภาพสว่าง ระบบอาจเข้าใจว่าความสว่างสัมพันธ์กับการอ่านได้ ทั้งที่ภาพสว่างจากแสงสะท้อนอาจอ่านไม่ได้ Label หรือป้ายคำตอบจึงต้องระบุสิ่งที่ต้องการจริง เช่น เห็นเข็มและหน่วยครบ ไม่ใช่เพียงผู้ตรวจรู้สึกว่าภาพดูดี
ในทางวิศวกรรม Feature คือค่าที่นำเข้าการเรียนรู้ ส่วนการฝึกคือการประมาณพารามิเตอร์จากตัวอย่าง การอนุมานใช้พารามิเตอร์ที่ล็อกแล้วกับข้อมูลใหม่ ต้องแยกสองช่วงนี้ชัดเจน รวมถึงการปรับสเกลข้อมูลและเกณฑ์ตัดสิน เพื่อให้การทดสอบสะท้อนสิ่งที่จะเกิดกับข้อมูลที่ระบบไม่เคยเห็น ไม่ใช่การทวนจำคำตอบเดิม
เลื่อนแผนภาพซ้าย–ขวาเพื่อดูรายละเอียดครบทุกส่วน
ตัวอย่างในบริบทอุตสาหกรรม
ตัวอย่างเชิงออกแบบ: ใช้ความคมชัด ความสว่าง และสัดส่วนแสงสะท้อนจำแนกภาพเกจว่าอ่านได้หรือควรตรวจซ้ำ เปรียบเทียบกับกฎความคมชัดแบบง่ายก่อนใช้โมเดลซับซ้อน
สมมติภาพจากกล้องหนึ่งคมแต่มีแสงสะท้อนทับปลายเข็ม ขณะที่อีกกล้องภาพมืดกว่าแต่เห็นรายละเอียดครบ การติดป้ายควรพิจารณาความสามารถในการอ่าน ไม่ให้ชื่อกล้องหรือความสว่างเป็นคำตอบแทน ผู้ตรวจควรมีตัวอย่างกรณีก้ำกึ่งและบันทึกเหตุผลที่ไม่เห็นตรงกัน เพื่อปรับนิยามก่อนเสียเวลาเปลี่ยนโมเดล
วิศวกรทดลองกฎง่ายและตัวจำแนกบนชุดแยกเดียวกัน แล้วตรวจภาพที่วิธีทั้งสองตัดสินต่างกัน หากโมเดลใช้ชื่อแฟ้มหรือวันถ่ายเพื่อเดาคำตอบ ต้องถอดข้อมูลนั้นออกหรือพิสูจน์ความเหมาะสมของการใช้ก่อน คะแนนที่ส่งออกควรระบุเกณฑ์ที่ใช้และเวอร์ชันตัวจำแนก เพื่อให้รู้ว่าการเปลี่ยนจำนวนภาพผ่านมาจากข้อมูลหรือจากการปรับกฎ
ขั้นตอนศึกษาและทดลอง
- 1 นิยาม label อ่านได้ให้ผู้ตรวจใช้เกณฑ์เดียวกัน
- 2 แยก train/validation/test ตามกล้องหรือวันถ่ายก่อนปรับพารามิเตอร์
- 3 ฝึก preprocessing เฉพาะ train และล็อก threshold จาก validation
วิธีประเมินและนิยามผล
ตรวจ confusion matrix โดยเน้นภาพอ่านไม่ได้ที่ถูกปล่อยผ่าน แยกผลตามกล้องและสภาพแสง ไม่ใช้ training accuracy เป็นผลทดสอบ
ตารางความสับสนแยกคำตอบจริงกับคำตอบที่ทำนาย ทำให้เห็นสองความผิดต่างกัน คือปฏิเสธภาพที่อ่านได้กับยอมรับภาพที่อ่านไม่ได้ การเลือกเกณฑ์คะแนนควรผูกกับผลกระทบของทั้งสองแบบ ไม่ใช่มองเพียงร้อยละรวม โดยให้ผู้ใช้งานระบุว่ากรณีใดต้องตรวจซ้ำ และวิศวกรรายงานจำนวนตัวอย่างในแต่ละช่องด้วย
ตรวจการรั่วของข้อมูลด้วยกลุ่มภาพจากเรือนเกจหรือช่วงถ่ายเดียวกัน เพราะภาพที่คล้ายมากข้ามชุดทำให้ผลดูดีเกินการใช้งานจริง ควรตรวจค่าคุณลักษณะที่หายไปและช่วงค่าที่ไม่เคยพบในการฝึกด้วย หากผลลดเฉพาะกล้องใหม่ ให้สำรวจความต่างของข้อมูลต้นทางก่อนสรุปว่าอัลกอริทึมเดิมล้มเหลวหรือเลือกฝึกใหม่ทันที เก็บเกณฑ์ตัดสินเดิมไว้เทียบด้วย เพื่อแยกผลจากการเปลี่ยนข้อมูลกับผลจากการเปลี่ยนเกณฑ์
ข้อจำกัดและกรณีผิดพลาด
ข้อมูลที่เก็บเฉพาะกะกลางวันอาจไม่ครอบคลุมกะกลางคืน และความสัมพันธ์ในข้อมูลไม่ยืนยันเหตุและผลของกระบวนการ
คำตอบกำกับอาจผิดหรือไม่สม่ำเสมอ แม้มีภาพจำนวนมากก็ไม่ได้แก้ปัญหานี้โดยตัวมันเอง หากผู้ตรวจบางคนยอมรับเข็มที่บังบางส่วนและอีกคนไม่ยอมรับ โมเดลจะเรียนขอบเขตที่คลุมเครือ ควรแยกความไม่แน่นอนของคำตอบออกจากความผิดของการทำนาย และมีกรณีที่ส่งต่อให้ผู้รับผิดชอบตัดสินตามเกณฑ์เดียวกัน
โมเดลที่เหมาะกับชุดหนึ่งอาจไม่เหมาะกับชุดใหม่ การเพิ่มคุณลักษณะช่วยแยกกรณีได้แต่เพิ่มภาระเก็บและตรวจคุณภาพข้อมูล ส่วนการฝึกบ่อยเพิ่มภาระยืนยันผลแต่ไม่ได้รับประกันว่าจะดีขึ้น ต้องมีเวอร์ชันเดิมให้เปรียบเทียบและย้อนกลับ รวมทั้งหลีกเลี่ยงการอธิบายว่าคุณลักษณะสำคัญเป็นสาเหตุทางกายภาพ หากไม่มีหลักฐานที่รองรับข้อสรุปนั้น
รายการตรวจสอบก่อนนำไปใช้
- มี baseline ที่ไม่ใช้ ML หรือไม่
- ภาพเกจเดียวกันรั่วข้ามชุดหรือไม่
- ใครเป็นผู้อนุมัติเมื่อจะฝึกใหม่