
ระดับเนื้อหา: Overview / Implementation considerations
หลักการและการเลือกใช้
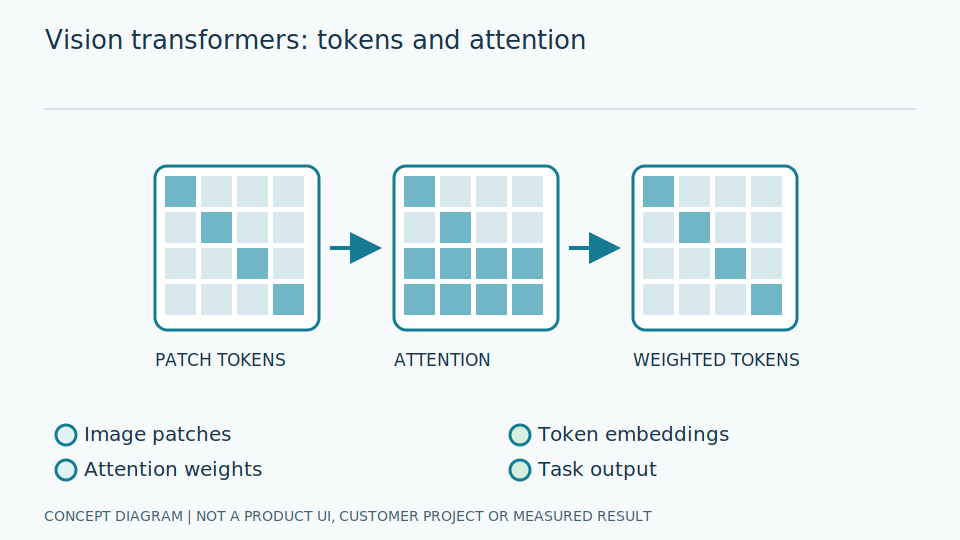
Vision Transformer แบ่งภาพเป็น token และใช้ attention เชื่อมข้อมูลระหว่างตำแหน่ง ต่างจาก inductive bias แบบบริเวณใกล้เคียงของ CNN ค่าใช้จ่าย attention มาตรฐานเพิ่มตามจำนวน token กำลังสอง แต่สถาปัตยกรรมที่ใช้ window อาจต่างออกไป
Token เป็นหน่วยข้อมูลที่ได้จากส่วนภาพหรือ patch ไม่ใช่คำที่โมเดลเข้าใจตามความหมายมนุษย์ Attention ช่วยนำข้อมูลจากตำแหน่งต่าง ๆ มาผสมตามน้ำหนักที่คำนวณขึ้น จึงอาจใช้บริบทกว้าง เช่น ความสัมพันธ์ระหว่างเข็มกับสเกล แต่ต้องมีการฝึกและคำตอบที่ตรงงาน ไม่ได้รู้ว่าสัญลักษณ์หน่วยหมายถึงอะไรเพียงเพราะเชื่อมข้อมูลหลายตำแหน่งได้
Inductive bias คือข้อสมมติในโครงสร้างที่ช่วยจำกัดสิ่งที่โมเดลเรียน เช่น CNN เน้นพื้นที่ใกล้กัน ส่วน transformer มีวิธีเชื่อมต่างออกไป วิศวกรต้องตรวจขนาด patch การเข้ารหัสตำแหน่ง และรูปร่างข้อมูลของรุ่นที่เลือก Patch ใหญ่ลดจำนวนหน่วยแต่เสี่ยงรวมเข็มบางกับพื้นหลัง ต้องทดสอบตามรายละเอียดสำคัญจริง ไม่ใช้ขนาดภาพทั้งหมดเป็นตัวแทนว่าข้อมูลพอ
เลื่อนแผนภาพซ้าย–ขวาเพื่อดูรายละเอียดครบทุกส่วน
ตัวอย่างในบริบทอุตสาหกรรม
ตัวอย่างเชิงออกแบบ: ทดลอง transformer กับ CNN เพื่อแยกองค์ประกอบหน้าปัดที่มีบริบทหลายส่วน โดยใช้ข้อมูลและข้อจำกัดหน่วยความจำเดียวกัน ไม่สรุปว่า transformer ดีกว่าเสมอ
สมมติหน้าปัดมีเข็มหลายอันและป้ายชื่อที่ช่วยแยกชนิด การใช้บริบททั้งภาพอาจช่วยเลือกองค์ประกอบ แต่ถ้าป้ายชื่อสัมพันธ์กับคำตอบเฉพาะชุดฝึก โมเดลก็อาจพึ่งป้ายแทนรูปร่าง ต้องทดสอบหน้าปัดแบบใหม่และตรวจกรณีป้ายไม่ชัด ไม่อ้างว่ามองภาพกว้างขึ้นย่อมทำให้เข้าใจสเกลหรือแยกเข็มที่ใช้จริงได้โดยไม่มีข้อมูลกำกับที่เหมาะสม
วิศวกรตรวจภาพหลังแบ่ง patch ว่ารายละเอียดสำคัญยังมีอิทธิพลต่อผล และเปรียบเทียบวิธีด้วยชุดแยกเดียวกันพร้อมงบการฝึกที่อธิบายได้ หากส่งออกรุ่นที่รับขนาดภาพคงที่ ต้องตรวจว่าระบบรับภาพไม่ส่งรูปแบบอื่นโดยเงียบ ใช้ผลจากภาพอ้างอิงเทียบค่าก่อนกับหลังส่งออก รวมทั้งตรวจ operator ที่รองรับ ไม่ถือว่ารูปแบบไฟล์เหมือนกันแล้วการคำนวณทุกส่วนเท่ากัน
ขั้นตอนศึกษาและทดลอง
- 1 เลือก patch size ที่ไม่ทำรายละเอียดเข็มหาย
- 2 ตรวจข้อมูล pretraining และปรับ fine-tune ตามข้อมูลจริง
- 3 ส่งออก runtime แล้ววัดความเข้ากันของ operator และ input shape
วิธีประเมินและนิยามผล
เปรียบเทียบ task metric, latency และ peak memory ที่ resolution เท่ากัน พร้อม learning curve ตามจำนวนข้อมูลและผลบน domain ใหม่
Task metric คือคะแนนที่ตรงคำถามงาน เช่น ความผิดมุมหรือคุณภาพพื้นที่ ส่วน peak memory คือหน่วยความจำสูงสุดระหว่างการประมวลผล ต้องรายงานควบคู่จำนวนภาพที่ทำพร้อมกันและขนาดข้อมูล เพราะค่าที่วัดกับภาพเล็กไม่แสดงภาระเมื่อใช้งานจริง การเปรียบเทียบควรแยกผลของสถาปัตยกรรมจากข้อมูล pretraining และการปรับภาพที่ต่างกันด้วย
วิศวกรตรวจผลรายขนาดเป้าหมายและกรณีข้อมูลน้อย พร้อมกราฟการฝึกเพื่อเห็นว่าระบบจำตัวอย่างหรือยังเรียนไม่พอ วัดเส้นทางหลังส่งออกจริงทั้งการเตรียม token และการส่งผล ไม่เฉพาะช่วงที่สะดวกบนเครื่องฝึก หากขนาดภาพเพิ่มแล้วหน่วยความจำกระโดด ให้ตรวจจำนวน token และชนิด attention ก่อนเลือกอุปกรณ์เพิ่ม และเก็บเงื่อนไขทั้งหมดให้ทดสอบซ้ำได้
ข้อจำกัดและกรณีผิดพลาด
โมเดลใหญ่ใช้ทรัพยากรสูงและอาจไวต่อข้อมูลน้อย attention map ไม่ใช่คำอธิบายเชิงเหตุผลหรือหลักฐานว่าโมเดลเข้าใจสเกล
Attention map แสดงน้ำหนักที่ใช้ผสมข้อมูลในส่วนหนึ่งของโมเดล ไม่ใช่คำอธิบายครบว่าเหตุใดผลสุดท้ายถูกหรือผิด พื้นที่ที่น้ำหนักสูงอาจเป็นสิ่งรบกวนได้ ต้องใช้กรณีตรวจที่มีคำตอบจริงและการเปลี่ยนข้อมูลอย่างเหมาะสมเพื่อสำรวจ ไม่อ่านภาพแผนที่แล้วสรุปว่าโมเดลใช้หลักฟิสิกส์หรือเข้าใจหน่วยตามความหมายของผู้อ่าน
การเพิ่มจำนวน token อาจรักษารายละเอียดแต่เพิ่มการคำนวณในวิธีมาตรฐานอย่างรวดเร็ว ส่วนการใช้ window จำกัดพื้นที่เชื่อมและมีข้อแลกเปลี่ยนของรุ่นนั้น ต้องเลือกจากผลกับทรัพยากรจริง ไม่กล่าวว่ารุ่นใดเหนือกว่าเสมอ เอกสารโมเดลเป็นแนวทางทดลองและตรวจข้อจำกัด ไม่ยืนยันความสามารถปัจจุบันของผลิตภัณฑ์หรือผลการใช้งานที่ยังไม่มีข้อมูลทดสอบเฉพาะรองรับ
รายการตรวจสอบก่อนนำไปใช้
- ขนาด token เหมาะกับเป้าหมายหรือไม่
- เปรียบเทียบ baseline ด้วยงบฝึกใกล้กันหรือไม่
- ฮาร์ดแวร์รองรับ operator ที่ต้องใช้หรือไม่