
ระดับเนื้อหา: Overview / Implementation considerations
หลักการและการเลือกใช้
Reinforcement Learning เรียนนโยบายเลือก action จาก reward ในสภาพแวดล้อมตามเวลา การให้ reward ไม่ครบอาจนำไปสู่นโยบายที่ได้คะแนนดีแต่ผิดเจตนา หัวข้อนี้เป็นความรู้เชิงวิจัย ไม่ใช่การยืนยันว่ามีระบบควบคุมเครื่องจักรให้ใช้งาน
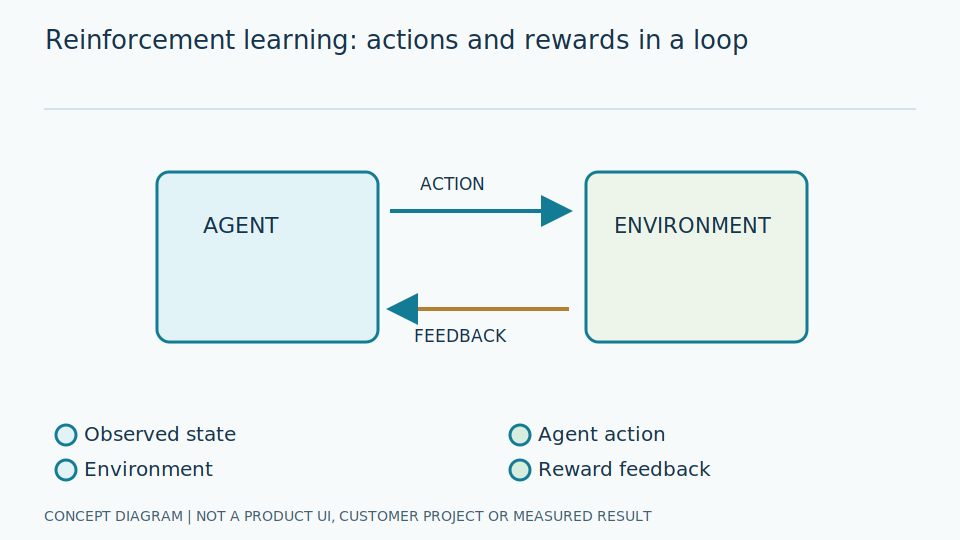
RL คือการเรียนจากผลของการเลือกในลำดับเวลา State คือข้อมูลสภาพที่ใช้ตัดสิน action คือทางเลือก และ reward คือคะแนนตอบกลับ Policy หรือนโยบายบอกว่าจะเลือกอย่างไร แต่คะแนนที่ตั้งไม่ครบอาจทำให้ระบบชนะเป้าตัวเลขโดยละเลยข้อจำกัดจริง จึงต้องนิยามสิ่งที่ห้ามและขอบเขตการจำลอง ไม่ถือว่ารางวัลสูงหมายถึงวิธีเหมาะกับอุปกรณ์หรือปลอดภัยโดยอัตโนมัติ
วิศวกรตรวจว่าข้อมูล state รวมสิ่งที่จำเป็นและมีพร้อมก่อนเลือก action จริงในแบบจำลองหรือไม่ พร้อมแยก constraint หรือข้อจำกัดที่ต้องรักษาจาก reward การหักคะแนนเมื่อผิดไม่ทดแทนกลไกป้องกันอิสระ Return คือผลรวมรางวัลตามกติกาเวลา ใช้เปรียบวิธีใน simulator ที่ตรวจสมมติฐานแล้วเท่านั้น และต้องรักษาขอบเขตวิจัย ไม่ส่งนโยบายไปลองเลือกกับเครื่องจักรจริงโดยไม่มีการประเมินและอนุมัติ
เลื่อนแผนภาพซ้าย–ขวาเพื่อดูรายละเอียดครบทุกส่วน
ตัวอย่างในบริบทอุตสาหกรรม
ตัวอย่างแนวคิดใน simulator: เปรียบเทียบนโยบายจัดลำดับงานกับกฎเดิม โดยมีข้อจำกัดทรัพยากรชัดเจน ไม่ทดลอง exploration กับเครื่องจักรหรือ interlock จริง
สมมติแบบจำลองจัดลำดับงานให้คะแนนจากจำนวนงานที่เสร็จ แต่ไม่ได้คิดเวลารอของบางกลุ่ม นโยบายอาจปล่อยงานยากรอไม่จบเพื่อทำคะแนนดี นี่เป็น reward hacking หรือการได้คะแนนตามกฎแต่ผิดเจตนา ต้องตรวจหลายผล เช่น งานค้างและการละเมิดเงื่อนไข ไม่ดูผลรวมรางวัลเพียงอย่างเดียว และการทดสอบต้องอยู่ในข้อมูลจำลองที่ไม่สั่งอุปกรณ์จริง
วิศวกรสร้างกรณีจำลองที่รู้ข้อจำกัดและเทียบกฎจัดงานเดิม พร้อมหลาย seed หรือค่าตั้งการสุ่ม ตรวจว่านโยบายใช้ข้อมูลอนาคตที่แบบจำลองเผลอให้หรือไม่ หากประเมิน offline จากข้อมูลนโยบายเดิม ต้องถามว่ามีตัวอย่าง action ของนโยบายใหม่เพียงพอให้สรุปหรือไม่ ไม่ประมาณผลของทางเลือกที่ไม่เคยสังเกตแล้วกล่าวว่าใช้จริงดีกว่า และไม่ทดลอง exploration บนวงจร safety
ขั้นตอนศึกษาและทดลอง
- 1 นิยาม state/action/reward และข้อห้ามในสภาพแวดล้อมจำลอง
- 2 ตรวจ simulator กับข้อมูลที่อนุญาตและทดสอบ reward hacking
- 3 ประเมิน offline พร้อมผู้เชี่ยวชาญก่อนพิจารณาการทดลองที่ผ่านการอนุมัติ
วิธีประเมินและนิยามผล
รายงาน return ควบคู่การละเมิด constraint ความแปรปรวนหลาย seed และผลเทียบ baseline การประเมิน offline ต้องพิจารณาว่าข้อมูลครอบคลุม action ของนโยบายใหม่หรือไม่
ผลเฉลี่ยรางวัลอาจซ่อนกรณีผิดเงื่อนไขซึ่งมีผลมาก ต้องแจกแจงชนิดและจำนวนการละเมิด พร้อมกรณีท้าทายที่ตั้งไว้ก่อนฝึก การใช้หลาย seed ช่วยเห็นผลที่ต่างจากการสุ่ม แต่ไม่ทดแทนความถูกของ simulator ต้องรายงานขอบเขตสมมติฐานและข้อมูลที่ใช้ตรวจแบบจำลอง ไม่อ้างผลรางวัลเป็นความประหยัดหรือประสิทธิภาพงานจริงที่ยังไม่ได้วัดในกระบวนการอนุมัติ
วิศวกรตรวจนโยบายกับสถานการณ์จำลองใหม่และเทียบ baseline ภายใต้เงื่อนไขเดียวกัน พร้อมกรณีข้อมูลขาดหรือสถานะนอกช่วง ถ้าผล offline ต้องอาศัยสมมติฐานมาก ให้บอกความไม่แน่นอนและสิ่งที่ยังประเมินไม่ได้ การใช้เอกสาร RL และกรอบความเสี่ยงเป็นแนววิจัยและออกแบบ ไม่รับรองนโยบายหรือความปลอดภัยของอุปกรณ์ และไม่เป็นเหตุข้ามการอนุมัติจากผู้เชี่ยวชาญหน้างาน
ข้อจำกัดและกรณีผิดพลาด
sim-to-real gap และการกระจายข้อมูลจากนโยบายเดิมทำให้ผลประเมินคลาดเคลื่อน ระบบ safety ต้องแยกอิสระและไม่ถูกแทนด้วย reward penalty
Sim-to-real gap คือความต่างระหว่างแบบจำลองกับของจริง เช่น เวลาตอบและเงื่อนไขที่แบบจำลองละไว้ นโยบายอาจอาศัยช่องว่างของแบบจนผลดีแต่ไม่ใช้ได้จริง การเพิ่มความละเอียดแบบช่วยบางส่วนแต่เพิ่มต้นทุนและยังมีข้อจำกัด ต้องบอกสิ่งที่ไม่ครอบคลุมและไม่กล่าวว่าได้รางวัลสูงใน simulation แล้วพร้อมควบคุมเครื่องจักรหรือรับรองผลลัพธ์ในโลกจริง
การสำรวจทางเลือกหรือ exploration จำเป็นต่อการเรียนบางวิธีแต่เสี่ยงเมื่อกระทำต่อระบบจริง จึงจำกัดใน simulator ตามโจทย์นี้และรักษาระบบ safety อิสระ ห้ามใช้ reward penalty เป็นเหตุถอดข้อป้องกัน ตัวอย่างให้ความรู้เรื่องนโยบายและการประเมิน ไม่ยืนยันว่าผลิตภัณฑ์มี RL หรือควบคุมอัตโนมัติปัจจุบัน และการพิจารณาใช้งานใดต้องผ่านผู้รับผิดชอบกับกระบวนการประเมินที่เหมาะสม
รายการตรวจสอบก่อนนำไปใช้
- อยู่ใน simulation scope ชัดหรือไม่
- มี baseline และข้อจำกัดที่ทดสอบได้หรือไม่
- ไม่มีการ bypass ระบบ safety หรือไม่